Давайте сменим тему и поговорим о более абстрактных концепциях MongoDB. Довольно просто объяснять новые термины и новый синтаксис. Гораздо сложнее говорить о моделировании в терминах новой парадигмы. Смысл в том, что большинство из нас привыкли пробовать любую новую технологию, моделируя реальные задачи. Мы поговорим об этом, но в конечном счете вы должны попрактиковаться и изучить реальный код.
Когда речь заходит о моделировании данных, то документ-ориентированные базы данных не настолько сильно отличаются от реляционных, как другие NoSQL-решения. Существующие различия не столь велики, однако это не уменьшает их важности.
Ссылки и объединение коллекций
Встроенные документы, ссылки и серверное объединение — разные инструменты моделирования. MongoDB поддерживает $lookup — стадию aggregation pipeline для left outer join с другой коллекцией в той же базе. Поэтому утверждение «MongoDB не поддерживает JOIN» неверно для текущих версий. Производительность зависит от объёма данных, фильтров и индексов; объединения нельзя объявить немасштабируемыми вообще.
Когда связи представлены идентификаторами, приложение может выполнить дополнительный запрос либо использовать $lookup. Ниже показана ручная связь: у сотрудника manager хранит _id другого сотрудника. Мы явно задаём идентификаторы, чтобы пример был воспроизводимым.
db.employees.insertOne({_id: ObjectId("4d85c7039ab0fd70a117d730"), name: 'Leto'})
Теперь добавим пару сотрудников и сделаем Leto их менеджером:
db.employees.insertOne({_id: ObjectId("4d85c7039ab0fd70a117d731"), name: 'Duncan', manager: ObjectId("4d85c7039ab0fd70a117d730")});
db.employees.insertOne({_id: ObjectId("4d85c7039ab0fd70a117d732"), name: 'Moneo', manager: ObjectId("4d85c7039ab0fd70a117d730")});
(стоит повторить, что _id может быть любым уникальным значением. Поскольку в жизни вы скорее всего станете использовать ObjectId, мы также здесь используем его.)
Чтобы найти всех сотрудников, принадлежащих Leto, выполним просто:
db.employees.find({manager: ObjectId("4d85c7039ab0fd70a117d730")})
Здесь связь хранится явно в manager, а фильтр находит подчинённых. Для включения данных менеджера можно выполнить отдельный запрос либо $lookup; подходящий индекс выбирается под конкретную форму запроса.
Массивы и вложенные документы
Вместо дополнительного запроса часть связанных данных можно включить в документ. Массив идентификаторов удобен, например, если у сотрудника несколько менеджеров:
db.employees.insertOne({_id: ObjectId("4d85c7039ab0fd70a117d733"), name: 'Siona', manager: [ObjectId("4d85c7039ab0fd70a117d730"), ObjectId("4d85c7039ab0fd70a117d732")] })
А самое интересное, что в одних документах manager можно сделать скалярным значением, а в других — массивом. А наш предыдущий запрос find сработает в обоих случаях:
db.employees.find({manager: ObjectId("4d85c7039ab0fd70a117d730")})
Массив значений упрощает часть запросов, но не заменяет таблицу связи во всех моделях. Выбор зависит от кардинальности, размера массива и способа изменения связей.
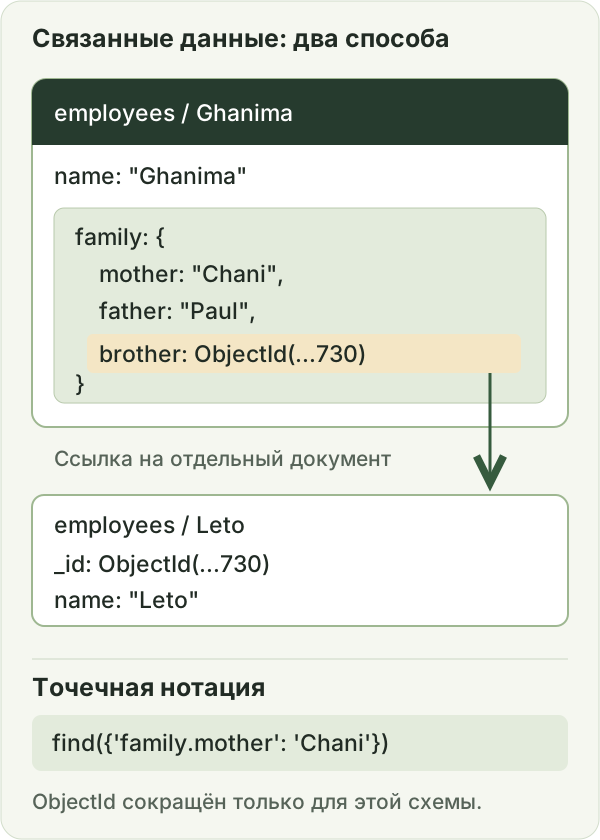
Кроме массивов MongoDB также поддерживает вложенные документы. Попробуйте вставить документ со вложенным документом, например:
db.employees.insertOne({_id: ObjectId("4d85c7039ab0fd70a117d734"), name: 'Ghanima', family: {mother: 'Chani', father: 'Paul', brother: ObjectId("4d85c7039ab0fd70a117d730")}})
Вложенные документы можно запрашивать с помощью точечной нотации:
db.employees.find({'family.mother': 'Chani'})
Мы кратко обсудим, где могут использоваться вложенные документы, и как их следует применять.
DBRef
DBRef — соглашение о представлении ссылки, включающей коллекцию и идентификатор, иногда имя базы. Оно не заставляет сервер автоматически загрузить связанный документ. Поддержка разрешения ссылки зависит от конкретного драйвера или ODM; обычные ручные ссылки часто проще. Перед использованием проверьте контракт своей библиотеки.
Денормализация
Денормализация сохраняет часть связанных данных рядом с основным документом. Это может уменьшить число чтений или зафиксировать историческое значение, например имя автора на момент публикации. Цена — дублирование и выбор стратегии обновления; такой выбор нужно обосновать запросами, а не общим утверждением о преимуществах NoSQL.
В форуме пост может хранить userId и снимок имени автора: user: {id: ObjectId("4d85c7039ab0fd70a117d730"), name: "Leto"}. Если показывается имя на момент публикации, снимок может оставаться неизменным. Если интерфейс должен всегда показывать текущее имя, после переименования потребуется обновлять все связанные посты либо получать имя отдельно. Один вызов updateMany способен изменить много документов; это не постоянная стоимость одной небольшой записи и не автоматическая атомарность всей группы.
Не всем легко приспособиться к такому подходу. Во многих случаях даже не имеет смысла этого делать. Всё же не бойтесь экспериментировать с таким подходом. Иногда это бывает полезным — чуть ли не единственным правильным — решением.
Что выбрать?
Также полезной стратегией в случаях отношения «один-ко-многим» или «многие-ко-многим» является массив идентификаторов. Бытует мнение, что DBRef используется не так часто, но конечно вы можете поэкспериментировать с ним. Обычно начинающие разработчики не уверены что подойдёт им лучше — вложенные документы или DBRef.
BSON-документ ограничен 16 MiB. Это верхняя граница, а не целевой размер. Неограниченно растущий массив комментариев неудобен даже до достижения лимита. Встраивание подходит для ограниченных данных, которые обычно читаются вместе; ссылки — для независимого жизненного цикла, больших наборов и связей, которые выгоднее запрашивать отдельно. Пример небольшого вложенного объекта:
db.users.insertOne({name: 'leto', email: 'leto@dune.gov', account: {allowed_gholas: 5, spice_ration: 10}})
Это не означает, что можно недооценивать мощь вложенных документов, либо отбрасывать их, как мелкую, второстепенную утилиту. Намного проще живётся, когда структура ваших данных напрямую отображает структуру ваших объектов. Особенно ценным является то, что MongoDB позволяет запрашивать и индексировать поля вложенных документов.
Мало или много коллекций
Учитывая то, что коллекции не привязывают нас к конкретной схеме, вполне возможно обойтись одной коллекцией, имеющей документы разной структуры. Построенные на MongoDB системы, с которыми мне приходилось сталкиваться, как правило, были похожи на реляционные базы данных. Другими словами, то, что являлось бы таблицей в реляционной базе данных, скорее всего реализуется, как коллекция в MongoDB (таблицы-связки «многие-ко-многим» являются важным исключением).
Для блога решение зависит от запросов и роста: несколько ограниченных комментариев можно встроить в пост, а растущий поток лучше хранить отдельно с postId и нужным индексом. Ограничение 16 MiB само по себе не выбирает модель за вас; учитывайте частоту чтений, обновлений и дублирование.
Проверьте модель на типичных запросах и ожидаемом росте данных. Сравните число запросов, размер документов, индексы и стоимость обновления дублированных полей. Универсального правила «всегда встраивать» или «всегда ссылаться» нет.
В этой главе
Целью этой главы было представить некоторые полезные рекомендации для моделирования данных в MongoDB. Если угодно, стартовую точку. Моделирование в документ-ориентированных системах отличается от такового в реляционных, но не так уж сильно. Здесь намного больше гибкости, но есть одно ограничение, хотя для разработки новой системы это подходит, как правило, неплохо. Не выходит только у тех, кто не пробует.